その時代、何を目指した?
新しいサンプルを作るプログラムに、何を直せばよいか教えたい。GANでは、その判断を学ぶもう一つのネットワークを置きます。
「この写真は何か」を見分けるだけでなく、訓練データのような新しい例を作るには、どの方向へ生成器を改善すべきかという学習の目標が必要です。複雑な確率分布を直接扱う計算も難題でした。
実際には、何をした?
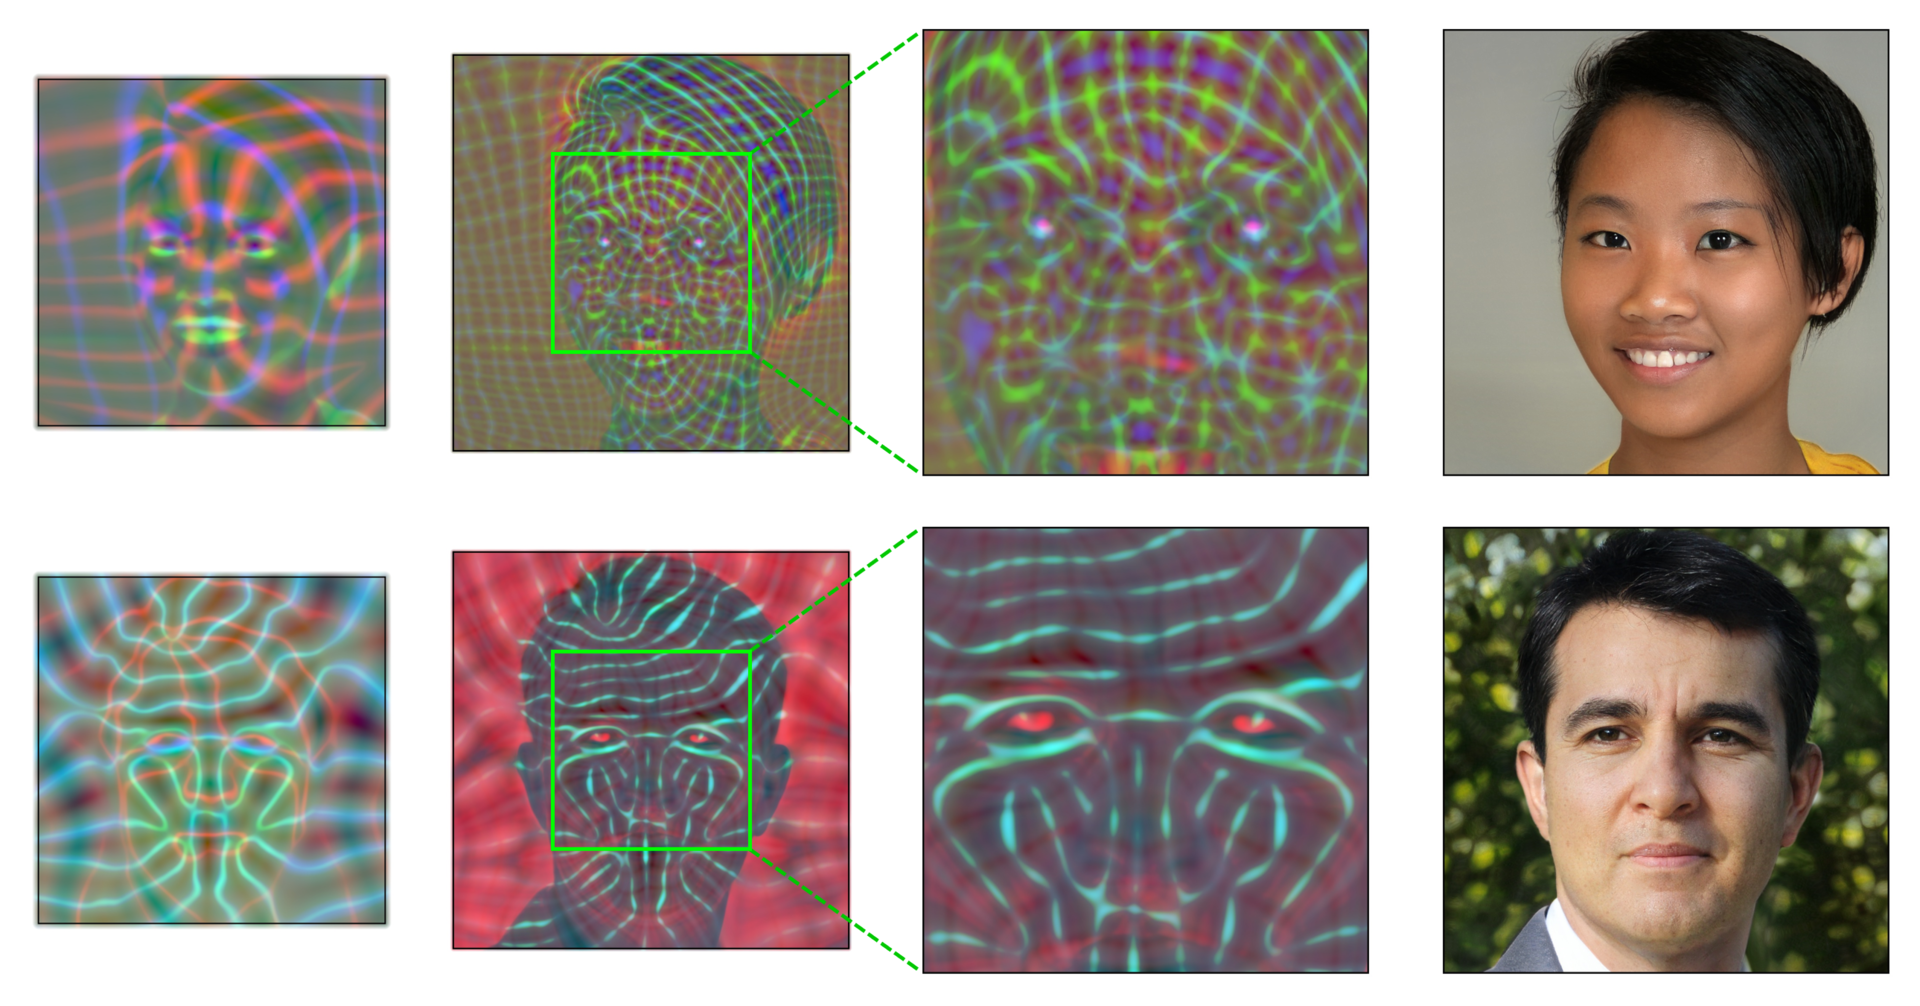
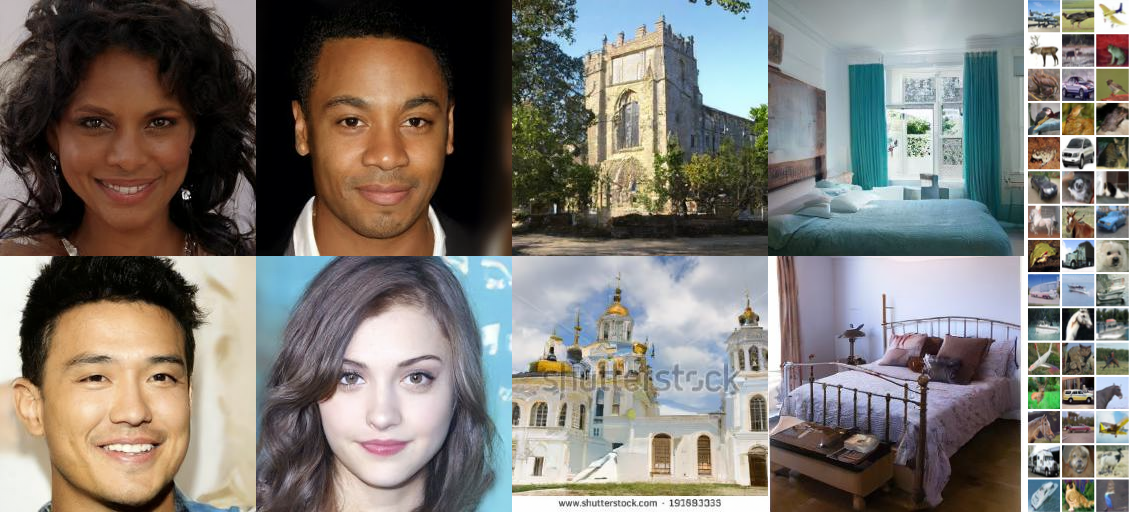
原論文の生成例は、生成器が学習した分布からサンプルを作る研究の結果です。識別器は訓練データ由来の例と生成された例を見分け、生成器はその判断を手がかりに学習します。
学習中の二者の関係と、学習後に画像を作る手順は別です。生成するときには生成器を使います。毎回、人が本物か偽物かを採点する工程や、文章による依頼が必須の方式ではありません。
実現を支えたしくみ
GANは、乱数からサンプルを作る生成器と、それが訓練データ由来か生成器由来かを見分ける識別器を一緒に学習させます。生成器は識別器の判断を手がかりに改善します。学習後にサンプルを作る段階では、基本的に生成器を使います。
二つのモデルを一緒に改善するため、片方だけが急に強くなるなど、学習の釣り合いが問題になります。論文の「Advantages and disadvantages」も合わせて読むと、生成例の見栄えだけからは分からない方法の性質が見えます。
何が変わり、何が残った?
原論文でも、2つのモデルの学習の歩調を合わせる難しさや、違う乱数から似た出力ばかりになる問題を挙げています。見栄えのよい一例だけでなく、出力の多様性を見る必要があると分かります。
編集の視点:「作る側と採点する側」の比喩は役割をつかむ助けになります。ただし識別器は、人間の美術の先生でも著作権の判定者でもありません。何を評価するために学習したかと、私たちが作品に求める条件は別です。
出典をたどる
本文は資料をもとにした日本語の解説です。引用画像は個別に出典を表示しています。研究の結果と現在の製品の提供条件は区別して読んでください。
- 研究論文Generative Adversarial Networks Goodfellow et al. / arXiv · 2014-06-10 · arXiv初公開
読む場所:Abstract; Adversarial nets; Advantages and disadvantages
生成器と識別器の相互学習、生成時の生成器、学習の同期と多様性の問題。
資料確認 2026-10-22