その時代、何を目指した?
音楽には、短い時間の音色と、時間をかけて続くリズムや旋律があります。細かい信号のまま扱う以外に、圧縮した記号列へ変換する方法があります。
音楽は音色だけでなく、リズムやメロディーが長い時間にわたり関係します。波形の細かい値をすべて扱う代わりに、音を圧縮した表現で扱いながら、文章や旋律の条件に沿わせる研究が進みました。
出典:Open sourcing AudioCraft: Generative AI for audio made simple and available to all / Simple and Controllable Music Generation
実際には、何をした?
MusicGenの論文は、圧縮した音のトークン列をTransformerで生成する構成を示します。文章と旋律による条件の違いは、論文のモデル説明と公式の研究紹介を行き来すると読み取れます。
AudioCraftの紹介にはMusicGen、AudioGen、EnCodecが登場します。これらはすべて同じ仕事をする名前ではありません。音楽生成、効果音などの生成、音の圧縮という役割を区別して読む必要があります。
出典:Open sourcing AudioCraft: Generative AI for audio made simple and available to all / Simple and Controllable Music Generation
資料を見て読む
 画像を原寸で開く
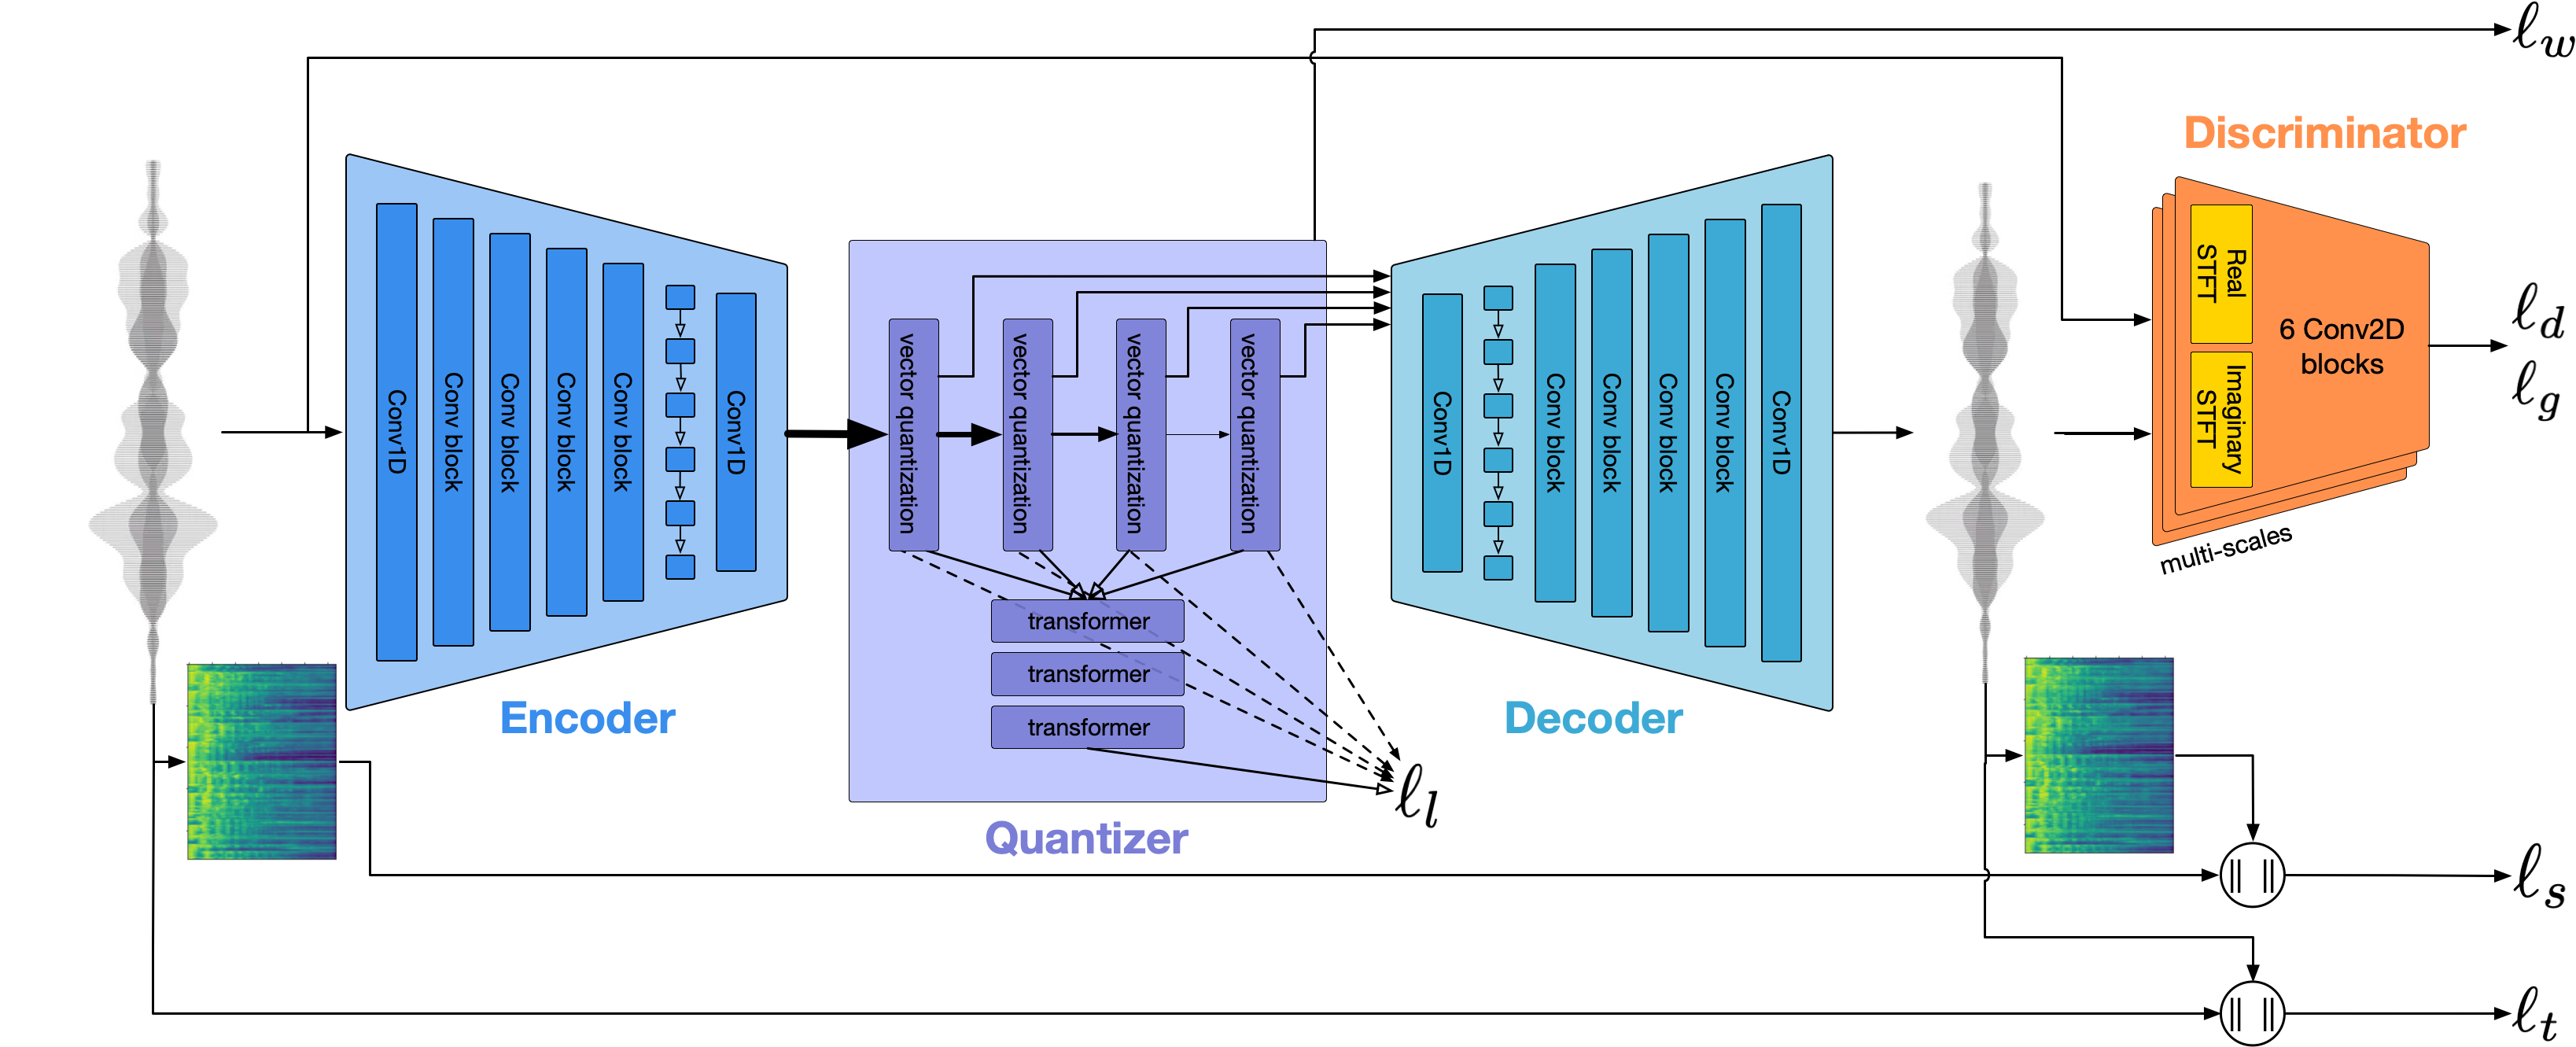
MusicGenが音を扱う背景として、EnCodecの圧縮構造を参照します。左で音を表現へ変え、中央で記号化し、右で波形に戻します。これはMusicGen全体の構造図ではありません。
Alexandre Défossez ほか / Meta AI · 研究資料の引用。著作権は各著作者に帰属。 · 原画像を改変せず掲載。表示時のみ縮小。 · 画像の出典
実現を支えたしくみ
AudioCraftに含まれるMusicGenの論文では、音を複数列のトークンとして表し、Transformerで生成する方法を説明しています。文章の内容や旋律の特徴を条件にできる設計です。音を扱う言語モデルのトークンは、文章の単語ではありません。
音声ファイルとして曲が出ることと、楽器ごとのトラックや楽譜として自由に編集できることは違います。どの表現を生成したのかが、その後にできる制作作業にも関係します。
出典:Open sourcing AudioCraft: Generative AI for audio made simple and available to all / Simple and Controllable Music Generation
何が変わり、何が残った?
音声として出力された曲を、自由に編集できる楽譜や楽器別トラックと同一視はできません。また、モデルが研究用に公開されていることと、生成物やモデルをあらゆる用途に無条件で使えることも別です。
編集の視点:「明るい」だけでなく、テンポ感、楽器、用途、変化してほしい区間を分けると、聴き比べる観点を作れます。波形・圧縮トークン・楽譜のどれを出力するかによって、後から直しやすい部分が変わります。
出典:Open sourcing AudioCraft: Generative AI for audio made simple and available to all / Simple and Controllable Music Generation
公開図の見どころ
MusicGenが音を扱う背景として、EnCodecの圧縮構造を参照します。左で音を表現へ変え、中央で記号化し、右で波形に戻します。これはMusicGen全体の構造図ではありません。
ここに掲載したのは研究者が公開した資料です。本サイトで同じモデルを実行した結果ではありません。表示を拡大して、原資料の文字や構成も確認できます。
出典をたどる
本文は資料をもとにした日本語の解説です。引用画像は個別に出典を表示しています。研究の結果と現在の製品の提供条件は区別して読んでください。
- 公式発表・研究資料Open sourcing AudioCraft: Generative AI for audio made simple and available to all Meta AI · 2023-08-02 · AudioCraft公開発表
読む場所:MusicGen; AudioGen; EnCodec
AudioCraft内の異なるモデルの役割、音の圧縮表現を使う音楽生成。
資料確認 2026-10-22 - 研究論文Simple and Controllable Music Generation Copet et al. / arXiv · 2023-06-08 · arXiv初公開
読む場所:Abstract; Model; Text and melody conditioning
音を複数の圧縮トークン列にし、Transformerで文章・旋律条件を反映して生成。
資料確認 2026-10-22 - 研究者の公開実装EnCodec — 音声コーデックの公式実装 Meta AI / EnCodec authors · 2022 · 対応するHigh Fidelity Neural Audio Compression論文の年。
読む場所:READMEのarchitecture図、圧縮モデルの説明、License
Encoder・Quantizer・Decoderで波形を圧縮・復元する構成。
資料確認 2026-10-29