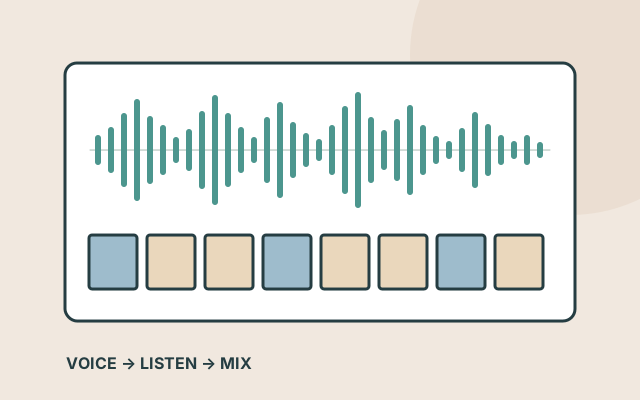
完成例・手順・比較から読む8秒のジングルを、耳と波形で仕上げる実践ガイドを開くこの分野のゴール
映像やゲームの用途に合った音を制作し、編集して使える形で保存する。
音の生成には、歌やBGMをつくる音楽生成、文章を読む音声合成、場面を伝える効果音生成などがあります。まずは何に使う音かを決めましょう。ゲームの待機画面、作品紹介のナレーション、短編映像の環境音では、必要な長さや目立ち方が違います。
AIが曲を出しても、狙ったテンポや構成、歌詞、発音になっているとは限りません。作り手の大切な仕事は、聴いて判断し、必要な部分を選び、修正して用途へ合わせることです。「好きなアーティストっぽく」より、楽器、速度、雰囲気、展開を言葉にすると、自分の意図を育てられます。
楽器が得意な人は、自分の演奏やメロディを出発点にできます。初めての人は、短いBGMを二つ比べるところから始められます。このロードマップでは、生成の体験から、簡単な音声編集、映像との同期、制作条件の記録へ進みます。
AIと、こんなことができる。
01雰囲気に合うBGMを試す
使う場面、楽器、速さ、明るさ、盛り上がる位置を指定し、候補を比較します。映像やゲームと一緒に聴くことが重要です。
例えば:自作ゲームの探索画面用に、静かなピアノと柔らかい打楽器のBGMを検討。
02声で情報を届ける
文章から読み上げ音声を生成し、速さ、間、言葉の読み方を確認します。使用できる声を選び、内容の伝わりやすさを調整します。
例えば:文化祭の展示を説明する30秒のナレーション。難しい固有名詞は読み方を指定。
03場面に合う音を加える
効果音や環境音をつくり、動画の出来事に合う位置へ配置します。音が多すぎないか、声を隠していないかも確認します。
例えば:ゲームで扉が開く音、雨の環境音、動画のタイトル表示に合わせる短い音。
ROADMAPLEARN → TRY → MAKE
5つのステップで、
「できる」を増やそう。
気になる段階から自由にどうぞ。前の段階を終える必要はありません。
01入門02入門03実践04実践05応用
01入門 · 目安 30〜60分
音を言葉で説明する
+
用途と音の特徴を短い制作メモにする。
学ぶこと
- テンポは速さ、音色は楽器などの音の質感。
- BGMには主役になる音と、説明を支える音がある。
- 作曲・歌声・読み上げ・効果音は別の目的として選ぶ。
やってみよう
- 身近な場面を一つ選び、必要な長さと役割を決める。
- 楽器、速度、雰囲気、歌の有無を言葉にする。
- 同じ用途で2案を生成し、違いをメモする。
結果を確かめる観点- 音を使う場所を説明できる。
- 候補を選ぶ理由が用途と結びついている。
この段階の実例を読む 02入門 · 目安 1〜2時間
曲の流れを考える
+
始まり・展開・終わりを持つ音をつくる。
学ぶこと
- イントロ、繰り返し、変化、終わりが曲の形をつくる。
- 歌詞を使う場合は、内容と実際の歌唱を別々に確認する。
- BPMなどの指示は、生成結果の正確さを保証しない。
やってみよう
- 「静かに始まる→少し広がる→穏やかに終わる」と展開を書く。
- 歌あり・歌なしなど、比べる条件を一つ変える。
- 使いたい区間を選び、違和感のある箇所に印を付ける。
結果を確かめる観点- 狙った展開が聴き取れる。
- 不要な歌声や不自然な切れ目を把握している。
この段階の実例を読む 03実践 · 目安 半日
声と音を編集する
+
生成結果を必要な長さと音量に整える。
学ぶこと
- 波形は音の強さの変化を時間で見たもの。
- フェードは音を少しずつ現したり消したりする操作。
- 音量を上げすぎると歪むため、耳とメーターで確認する。
やってみよう
- 音源をAudacityなどの編集ソフトへ読み込む。
- 必要な区間を切り出し、始まりと終わりを整える。
- ナレーションがある場合はBGMを控えめにし、書き出す。
結果を確かめる観点- 始まりと終わりに気になるクリック音がない。
- 声が聞き取れ、急に大きくなる部分がない。
この段階の実例を読む 04実践 · 目安 半日〜1日
映像やゲームと合わせる
+
音のタイミングと役割を作品の中で判断する。
学ぶこと
- 単体でよい曲でも、映像や台詞を邪魔する場合がある。
- 効果音は出来事の位置と合うと伝わりやすい。
- 繰り返すBGMはつなぎ目を実際に再生して確認する。
やってみよう
- 10〜30秒の映像や簡単なゲームへ音を組み込む。
- 音なし、BGMあり、効果音ありの違いを比べる。
- 複数回再生してタイミング、繰り返し、音量を調整する。
結果を確かめる観点- 音が内容の理解や雰囲気を助けている。
- 繰り返しや切り替えで目立つ違和感がない。
この段階の実例を読む 05応用 · 目安 2〜3日
自分の音の方向性をつくる
+
複数の場面に合う音を、統一した考え方で制作する。
学ぶこと
- 共通する楽器やフレーズは世界観をつなぐ手がかりになる。
- 区間の再生成やパート別編集は、対応機能を確かめて使う。
- 生成時のプランと利用条件、投入した素材の由来を残す。
やってみよう
- 同じゲームの「街」「探索」「達成」の3場面を想定する。
- 共通する音色と場面ごとの違いを決め、素材を制作する。
- 書き出し、音量、利用条件をそろえて作品集にする。
結果を確かめる観点- 場面の違いと作品全体の統一感が両立している。
- 音の選択、編集、素材の出所を説明できる。
この段階の実例を読む 練習時間は編集上の目安です。
TRY ITYOUR FIRST SMALL WIN
20〜30分から自作ゲームの静かな探索BGMをつくる
- 歌のないBGMをつくれるツールを開く。
- 下の指定で候補を生成し、最初から最後まで聴く。
- 落ち着き、音の密度、使う場面との相性で1つ選ぶ。
- 利用条件と保存方法を確認して、可能な形式で保存する。
- 編集ソフトで必要な部分を切り出し、作品と一緒に再生する。
架空の小さな森を探索するゲームのBGM。歌声なし。柔らかいピアノ、木の響きの打楽器、薄い環境音。ゆっくりした穏やかなテンポ。会話や効果音を邪魔しない控えめな音数。驚かせる大きな音や急な盛り上がりを避け、静かな雰囲気を保つ。
ゲーム画面と合わせて聴いたとき、雰囲気を助け、操作音や説明を邪魔しなければ第一歩は成功。
次は、何をつくる?
入門30分
同じ風景に2つのBGM
同じ画像に明るい音と不安な音を合わせ、印象がどう変わるか言葉にする。
完成形:2種類の音付きスライド
実践半日
30秒の音声ガイド
自分の作品説明を音声化。難しい読み方、間、声とBGMのバランスを調整する。
完成形:ナレーション音源と原稿
応用2日
ゲームの小さな音セット
決定、キャンセル、達成の効果音と待機画面のBGMを作り、音量と世界観をそろえる。
完成形:効果音3点+BGM1点
THEN → NOWUNDERSTAND THE CONTEXT
この分野は、どう変わった?
2016波形そのものを生成するWaveNet
DeepMindが、音の波形をニューラルネットワークで生成するWaveNetを発表。自然な読み上げ音声の研究に大きな進展を示しました。
出典を読む なぜ変わった? 仕組みと、今へのつながり
DeepMindの紹介は2016年9月8日、論文の初公開は同月12日。ここでは当時の原型の研究を説明しています。
何が難しかった?
録音した声の断片をつなぐ方法などでは、必要な音の組合せや自然な変化をどう作るかが課題になります。波形を直接作る場合も、1秒に何万点もある音の値を、前後のつながりを保って扱う必要があります。
何が変わった?
WaveNetは、すでにある音の値を条件に、次の値の分布を予測して波形を作りました。時間的に離れた情報も扱いやすい畳み込みの工夫を使い、論文では読み上げ音声の自然さや、音楽の断片生成を検証しました。
いま使うなら · 編集の視点
編集の視点:声の自然さ、指示した内容、曲全体の構成は別々に聴きます。短い音が自然に聞こえても、3分間の曲の展開が良いとは限りません。「何を単位に生成し、どれだけ長いまとまりを保てるか」が音の道具を見る軸になります。
できることと、限界
原型のWaveNetは音の値を順に作るため、生成の計算量が課題でした。また、論文が示した音楽の断片は、歌詞・曲構成・各楽器を自由に編集できる完成した作曲サービスを意味しません。
根拠となる一次資料 · 内容確認 2026-10-22研究・発表の説明と、学びへの応用案を区別しています。原論文と現在の製品が、同一の実装とは限りません。
文章から音楽や効果音へ
MetaはMusicGenやAudioGenを含むAudioCraftを公開。文章を条件にした音の生成を研究・実験する入口が広がりました。
出典を読む なぜ変わった? 仕組みと、今へのつながり
MusicGen論文の初公開は2023年6月8日。AudioCraftのまとめての公開発表は同年8月2日で、区別して記載しています。
何が難しかった?
音楽は音色だけでなく、リズムやメロディーが長い時間にわたり関係します。波形の細かい値をすべて扱う代わりに、音を圧縮した表現で扱いながら、文章や旋律の条件に沿わせる研究が進みました。
何が変わった?
AudioCraftに含まれるMusicGenの論文では、音を複数列のトークンとして表し、Transformerで生成する方法を説明しています。文章の内容や旋律の特徴を条件にできる設計です。音を扱う言語モデルのトークンは、文章の単語ではありません。
いま使うなら · 編集の視点
編集の視点:「明るい」だけでなく、テンポ感、楽器、用途、変化してほしい区間を分けると、聴き比べる観点を作れます。波形・圧縮トークン・楽譜のどれを出力するかによって、後から直しやすい部分が変わります。
できることと、限界
音声として出力された曲を、自由に編集できる楽譜や楽器別トラックと同一視はできません。また、モデルが研究用に公開されていることと、生成物やモデルをあらゆる用途に無条件で使えることも別です。
根拠となる一次資料 · 内容確認 2026-10-22研究・発表の説明と、学びへの応用案を区別しています。原論文と現在の製品が、同一の実装とは限りません。
曲を区間ごとに直す
ElevenMusicのComposerは、曲の一部の再生成や構成変更を案内。生成後の選択や編集を含む音づくりが進んでいます。
出典を読む 用途に応じてモデルを選ぶ
Sunoはv6のモデル群を発表。制作意図に合わせた制御と、新しい発想を得る使い方の両方に対応する方向を示しました。
出典を読む AI全体のあゆみを見る
GO DEEPERMAKE IT YOUR OWN
もう一歩、深く。
01ステムとMIDIの違いを知る
ステムは楽器などのまとまりごとの音声、MIDIは音の高さや長さなどの演奏指示です。音声を分けても自由に演奏し直せるMIDIになるわけではありません。目的に合う出力を選びます。
ループと場面転換を設計する
繰り返しの境目、効果音が鳴る瞬間、盛り上がる位置を実際の作品で確認します。「ループ向き」という指示だけに頼らず、複数回つないで聴きます。
自分の演奏と組み合わせる
自作メロディや演奏を参照できる機能を使う場合は、何を残したいかを明確にします。AIの提案をきっかけに、自分で弾き直したり、楽器を重ねたりする制作にも展開できます。
つまずいたら、ここを見直そう。
雰囲気だけで採用する
曲全体を聴くと、意図しない歌、言葉、急な展開が含まれることがあります。短い試聴で決めず、使用する区間を通して確認します。
歌詞と歌唱が一致していると思い込む
自分で書いた歌詞でも、実際の歌では言い間違いや抜けが起こることがあります。歌詞カードと照合し、必要なら区間を直します。
他人の声や音源を気軽に投入する
参照や声の再現には、自分の音や使用できる素材を選びます。実在の人の声を扱う場合は本人の許可を確認し、聴く人が本人の発言と取り違えない形にします。
出典と、次の寄り道。
機能や歴史は一次情報を参照しています。練習課題と学習順序はAI ATLASの編集提案です。
- WaveNet: A generative model for raw audio Google DeepMind · 2016年9月8日発表。音の波形を生成するニューラルネットワーク。 · 確認 2026-10-22
- Open sourcing AudioCraft: Generative AI for audio made simple and available to all Meta AI · 2023年8月2日発表。MusicGen・AudioGen・EnCodecを含む音声生成研究。 · 確認 2026-10-22
- Introducing v6 Suno · 2026年9月9日発表。用途の違いに対応する3つの音楽モデルを案内。 · 確認 2026-10-22
- Introducing Music v2 ElevenLabs · 2026年5月26日発表。音楽の構成・制御に関する更新。 · 確認 2026-10-22
- Introducing Music v2.5 ElevenLabs · 2026年9月11日発表。モデルとダウンロード条件の更新。提供者の品質評価は絶対的順位として扱わない。 · 確認 2026-10-22
- Composer: section-by-section song editing in ElevenMusic ElevenLabs · 2026年8月25日発表。曲全体を作り直さず、区間ごとに修正する機能。 · 確認 2026-10-22
- Text to Speech ElevenLabs Documentation · 文章から読み上げ音声を生成する公式ガイド。 · 確認 2026-10-22
- Audacity — Free, Open Source Audio Editor and Recorder Audacity · 無料の音声編集・録音ソフト。生成サービスではなく仕上げ用として紹介。 · 確認 2026-10-22