DATA LAB · 同じ表から、違う問いに答える
「たくさん売れた日」と「入場あたり売れた日」は違う。
文化祭の飲み物は、1日目に150杯、2日目に120杯売れました。では、2日目は調子が悪かったのでしょうか? 入場した回数で割ると、別の見え方になります。AIに「分析して」と頼むだけでなく、何を比べたいかを決め、計算・グラフ・説明を自分で確かめる練習です。
8行のデータはAI ATLASが作った架空の練習用です。実在の学校の実測値ではありません。掲載する集計とグラフは、配布するPythonコードを実際に実行して作成・検算しています。特定のAIサービスの画面や実行結果を再現したものではありません。
数字が苦手でも、足し算と割り算から始められます。結果を見る、自分で試す、誤読と修正を比べる、再現性・限界を検証するのどこから読んでも構いません。
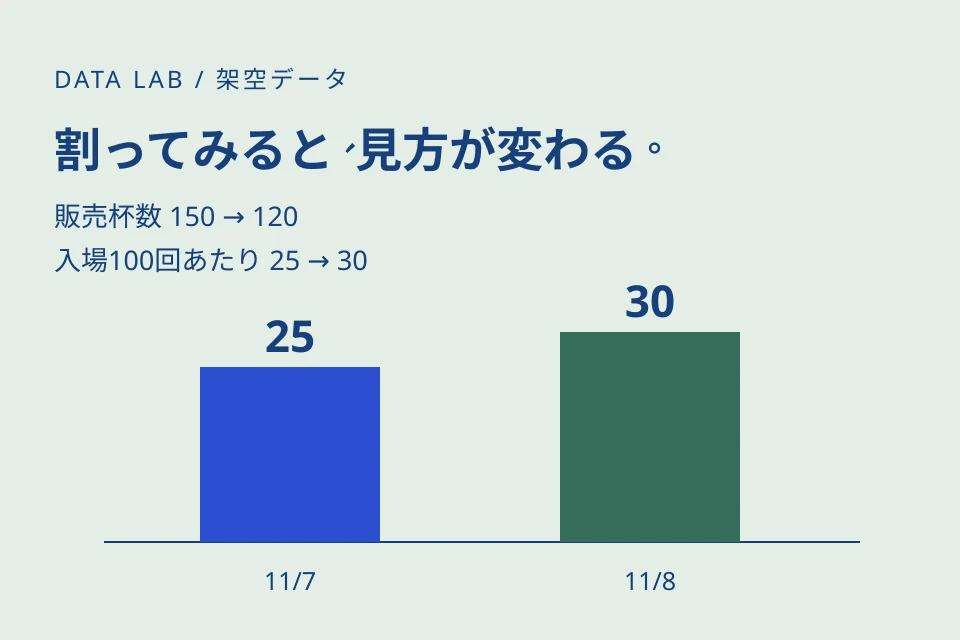
完成例:合計と「100回あたり」を、分けて見る。
| 日 | 入場カウント(回) | 販売杯数(杯) | 入場100回あたり(杯) |
|---|---|---|---|
| 11月7日 | 600 | 150 | 25 |
| 11月8日 | 400 | 120 | 30 |
| 2日間全体 | 1,000 | 270 | 27 |
在庫を振り返るなら、販売杯数。
入場規模をそろえるなら、100回あたり。
どちらのグラフも正しい計算です。ただし答えている問いが違います。「どちらがよい日だった?」だけでは、評価する基準が決まっていません。
データの定義と実行記録(TXT) · 日別集計(CSV) · 検算用の数値(JSON)
販売杯数を変えず、入場回数だけそろえると? 1日目の規模を2倍にしても日別の指標は変わらないのに、全体の値はどうなる? ブラウザー内の小さな実験で、分母と重みの違いを確かめられます。
入力の送信・保存、ログイン、学習記録はありません。初期値はこの記事と同じ架空データです。
初級:8行を読み、合計とグラフを確かめる。
必要なもの:このページだけでも答えを追えます。実際に計算するなら、表計算ソフト、計算を実行できるAIサービス、Python環境のどれか1つ。すべてを用意する必要はありません。外部サービスの契約・ログイン条件は、このページを読む条件とは別です。
1. 1行が何を表すかを読む。
CSVは、値をカンマで区切って保存した表の形式です。最初の行が列の名前、次の行からが記録。この例では「ある日の1時間」が1行です。
- day:日付。2026年11月7日と8日という架空の開催日です。
- slot:集計した1時間。10:00–11:00は10時以上11時未満とし、境界を二重に数えません。
- entries:会場の入場カウント。再入場も数えるため、別々の人の人数ではありません。
- cups:その時間帯の飲み物の販売杯数。同じ人が複数杯買うこともある設定です。
cups ÷ entries は「購入した人の割合」ではありません。人を1人ずつ追跡したデータではないからです。この記事では一貫して「入場100回あたりの販売杯数」と呼びます。値が100を超えることも、定義上はありえます。
day,slot,entries,cups
2026-11-07,10:00-11:00,120,24
2026-11-07,11:00-12:00,150,36
2026-11-07,12:00-13:00,180,54
2026-11-07,13:00-14:00,150,36
2026-11-08,10:00-11:00,80,24
2026-11-08,11:00-12:00,100,30
2026-11-08,12:00-13:00,140,42
2026-11-08,13:00-14:00,80,24
2. 問いと、確かめたい処理を伝える。
AIに頼むなら、表を添付または貼り付けて、次の依頼を使います。ファイルの取り扱いや機能はサービスによって異なるため、最初はこの架空データで試してください。実際の生徒名やアンケート原票は入れません。
添付または下記のCSVは、架空の文化祭2日間のデータです。
1行は1時間、entriesは再入場を含む入場カウント、cupsは販売杯数です。
調べたい問いは「販売杯数が多い日」と「入場100回あたりの杯数が多い日」が同じか、です。

1. 列名、8行あること、欠損、数値の型、dayとslotの重複を点検してください。
2. 問題があれば止まり、該当行を示してください。欠損を勝手に0にしないでください。
3. 日別のentriesとcupsを合計してください。
4. 日別および全体の「cups合計 ÷ entries合計 × 100」を計算してください。
5. 販売杯数と、入場100回あたりの杯数を、別々の棒グラフにしてください。
   数値軸は0から始め、単位と数値を表示してください。
6. 実行したコードと数値を示してください。コードを実行できない場合は、その旨を明示してください。
7. データから分かることと、原因としては断定できないことを分けて説明してください。
「購入率」「人数」と言い換えないでください。
ChatGPTの公式資料では、整理された表からの分析・作図やPythonによる処理を案内しています。ただし回答の見た目だけでコード実行済みとは判断せず、使った方法と実行結果を確認します。ファイルや利用量の上限はプラン等で異なります。
3. まず2つだけ、自分で検算する。
11月7日の販売杯数は、24+36+54+36=150杯。入場カウントは120+150+180+150=600回です。したがって、150÷600×100=25杯/入場100回。11月8日は120÷400×100=30杯/入場100回になります。
表計算で開いた場合、列がAからday、slot、entries、cupsの順なら、11月7日の杯数は「=SUM(D2:D5)」、全体の指標は「=SUM(D2:D9)/SUM(C2:C9)*100」。見出しを計算に混ぜず、保存したCSVが8行あることを確認してください。
4. グラフの見た目と、元の数値を照合する。
- 販売杯数の棒は150と120になっているか。単位は「円」や「人」ではなく「杯」か。
- 100回あたりの棒は25と30か。別々の図で指標を混ぜていないか。
- 棒の長さを読む図として、数値軸が0から始まっているか。
- 元データ・対象期間・架空データであることが読めるか。
5. 結論は、対象と限界もセットで。
この架空データの2日間では、販売杯数は11月7日が150杯で多い。一方、入場100回あたりでは11月8日が30杯で、7日の25杯より多い。天気、気温、価格、売り切れ、来場者の違いは記録していないため、その差の原因は分からない。
中級:正しい数字でも、見せ方で誤解が生まれる。
比較1:平均の平均は、何を平均した値?
日別の25と30を足して2で割ると27.5。でも2日間全体は、270÷1,000×100=27です。人数規模に相当する入場カウントが600回と400回で違うからです。
(25+30)÷2。問いが「日別指標の単純平均は?」なら、これはその答えです。
(150+120)÷(600+400)×100。問いが「2日間全体で入場100回あたり何杯?」なら、こちらです。
27は、25×0.6+30×0.4とも計算できます。600回分を60%、400回分を40%の重さにする加重平均です。「平均を出して」ではなく、何を同じ重さで扱うかを決めましょう。
比較2:棒の下を切ると、差が大きく見える。
差は5杯/入場100回、相対的には20%増です。「2倍」とは言えません。英国Government Analysis Functionの作図ガイドも、棒グラフの数値軸は0から始めることを勧めています。小さな差を強調したいなら点グラフなどを検討し、軸の範囲を明示します。すべての種類のグラフで必ず0が必要、という意味ではありません。
比較3:「売上が減った」と「原因が分かった」は違う。
このデータにあるのは杯数で、売上金額ではありません。さらに、「2日目にポスターを替えたから効果があった」と書くには、ポスター以外の条件や比較の設計が必要です。数値の差だけから、記録していない出来事を原因として補わないようにします。
次の説明を、CSVから確認できる範囲に直してください。
「2日目は新しいポスターが成功して、購入率が2倍になった」

確認すること:
- 記録にポスター変更の列はあるか。
- cupsとentriesは、人ごとの購入確率を表しているか。
- 25と30の比は本当に2倍か。
- 観察された差と、その差の原因を分けているか。
修正文と、直した理由を1つずつ示してください。
修正の答えを見る
「この架空データでは、2日目の入場100回あたりの販売杯数は30杯で、1日目の25杯より5杯多い(1.2倍)。購入した人の割合は計算できず、ポスターの効果もこの記録だけでは分からない。」指標、倍率、原因の3点を直しました。
失敗したCSVを、わざと点検する。
欠損と重複のある練習CSVを保存。1つの杯数が空白で、1つの時間帯が二重に入っています。配布コードは勝手に埋めず、空白の4行目と重複した10行目を示して停止します。行番号には見出し行も含みます。
- 空白を0にしたら:「未記録」が「0杯売れた」に変わります。この例で54杯のセルを0にすると、全体は21.6杯/入場100回になり、本来の27から下がります。
- 空白の行を消したら:入場180回も対象から外れます。216÷820×100≒26.34ですが、対象が全2日間ではなく「記録のある7時間」に変わります。
- どう直す?:元の記録に戻る。この教材では正しいCSVと照合できますが、実データでは分からない値を推測で埋めず、欠測があることを報告します。
上級:結果を再現し、結論の成立条件を確かめる。
1. 会話の答えではなく、実行する手順を残す。
集計・検証・SVG生成コード(Python)とCSVを同じフォルダに保存します。Python 3.9以降の標準ライブラリだけを使うため、このコードのための追加パッケージは不要です。掲載結果はPython 3.12.14で確認しました。
python analyze_festival.py festival.csv --out results
Pythonの環境によってはコマンド名がpython3です。実行するとresultsフォルダに集計CSV、JSON、2つのSVGができます。元のCSVは書き換えず、外部への送信もしません。別のデータに使うときは列の定義を合わせ、グラフの上限(この教材では180杯と40杯/入場100回)も見直してください。上限を超える場合は、誤った図をつくらず止まる設計です。
処理の中心は以下のように短く書けます。これは仕組みを読むための最小例です。配布版では、読み込み前後の列名・欠損・重複・分母0なども検査します。
import csv
from collections import defaultdict

by_day = defaultdict(lambda: {"entries": 0, "cups": 0})
with open("festival.csv", encoding="utf-8", newline="") as f:
    for row in csv.DictReader(f):
        day = by_day[row["day"]]
        day["entries"] += int(row["entries"])
        day["cups"] += int(row["cups"])

for date, values in sorted(by_day.items()):
    rate = values["cups"] / values["entries"] * 100
    print(date, values["entries"], values["cups"], rate)
期待される出力は「2026-11-07 600 150 25.0」と「2026-11-08 400 120 30.0」。保存ファイルのsummary.jsonには、入力データのSHA-256(ファイルが同じか照合するための識別値)とPythonの版も含めています。SHA-256が一致しても、元データが現実を正しく測った証明にはなりません。
2. 別の方法でも、同じ数字になるか。
小さな表なら電卓・表計算とコードを照合できます。大きな表ならpandasのgroupby(同じ日付などで行をまとめる処理)が便利です。ただし、ライブラリは欠損を除いて合計することがあるため、欠損検査を集計より先に行います。編集部では標準ライブラリ版とpandas版を別に実行し、600/400回、150/120杯、25/30という日別値と全体27の一致を確認しました。
照合用pandasコード · 自動テストコード。テストは既知の合計、欠損、重複、不正な数値、分母0、1回の入場で複数杯を買える定義、グラフの棒の高さを確認します。
3. 「データが多い」の単位を間違えない。
入場カウントが1,000回あっても、独立した1,000人の購入を観察したデータではありません。ここにあるのは、2日・8時間帯の集計値です。再入場や複数杯購入を含むので、これをそのまま「1,000人の購入率」とみなし、確率の誤差範囲を出すのは不適切です。
さらに、同じ日の時間帯は天候や催しを共有しており、完全に独立した観測とも限りません。難しい統計手法を付け足す前に、何を数え、どう集めたかを確認します。この教材では有意差や因果効果を検定せず、記述的な比較にとどめます。
4. ポスターの効果を知りたいなら、次の調査を設計する。
たとえば同じ催しで、比較する条件をそろえた複数の時間帯や場所にポスターA/Bをランダムに割り当てる案が考えられます。ただし、同じ人が両方を見る、時間帯の人通りが違う、売り切れが起きる、といった影響が残ります。目的に合う結果の指標、割り当て方、集計の単位を事前に決め、学校のルールを確認して実施します。「A/Bテスト」と呼ぶだけで公平な比較にはなりません。
5. 予測ではなく、条件付きの見積もりから始める。
仮に次回の入場カウントを500回と置き、今回の全体指標27をそのまま使うなら、500×27÷100=135杯。これは「同じ条件が続くなら」という計算で、次回を当てた予測ではありません。仮定を25〜30杯/入場100回に動かすと、125〜150杯になります。この範囲は選んだシナリオの幅で、統計的な信頼区間ではありません。
在庫を決めるなら、売り切れで失う機会と余ってしまう量、気温、開催時間、過去の記録なども必要です。まず足りない情報を挙げられることが、無理に一つの数字を言い切るより役立ちます。
道具の使い分け:表が小さい今は、仕組みを増やしすぎない。
| 道具・方法 | 選ぶ理由 | 見送る理由・注意 |
|---|---|---|
| 電卓・表計算 | 8行程度なら計算を目で追える | 手入力や数式の範囲ずれに注意 |
| 会話型AI+実行結果確認 | 問いの整理、コードの説明、グラフ案の比較 | 説明の説得力と数値の正しさは別。データを預ける条件も確認 |
| Pythonの保存コード | 同じ処理を再実行し、入力検査も自動化できる | 最初の環境準備とコードの理解が必要 |
| APIや自動収集基盤 | 定期的に大量のデータが更新されるときに検討 | 今回は8行なので不採用。認証・運用・費用の負担が効果を上回る |
この5問に答えられたら、結果を説明できる。
- 1行・1列・単位は何か。entriesを「人数」と呼ばない理由は?
- 日別合計と全体合計が一致するか。除外した行や空白はあるか。
- 150と120、25と30は、それぞれどの問いへの答えか。
- グラフの数値軸、倍率、説明文が、同じ比較を表しているか。
- 分かったことと、原因としては分からないことを分けたか。
理解を確かめる:25と30の平均は27.5。全体も27.5でよい?
全体の入場100回あたりを求めるなら、よくありません。2日間の分母が600回と400回なので、合計270杯÷合計1,000回×100=27です。「各日の指標を同じ重みで平均する」という別の問いなら27.5が答えになります。
理解を確かめる:2日目の方が暑かったから売れた、と書ける?
このCSVに気温はなく、天候や来場者の条件も比べていません。暑さは次に調べる仮説にはできますが、このデータが示した原因とは書けません。
次は数値の背景を調べる、文化祭の案内をつくる、同じ検査をコードで自動化するへ。どの分野でも「できた」と「確かめた」を分ける考え方が使えます。
公式資料と、計算の出どころ。
確認日:2026年10月22日(日本時間)。題材・CSV・計算例・比較図はAI ATLASの独自教材です。公式資料は、道具の機能・コードの仕様・作図の原則を確認するために参照しました。
- OpenAI:Data analysis with ChatGPT。表の整え方、Pythonを使う分析、コードと結果の確認。
- Microsoft:SUMで範囲内の値を合計する。セルの範囲を指定する式の公式解説。
- Python:csvモジュール。CSVを辞書形式で読み書きする仕様。
- pandas:How to calculate summary statistics。グループ集計、欠損を除外する集計の挙動。
- pandas:DataFrame.duplicated。指定した列の組み合わせによる重複検査。
- 英国Government Analysis Function:Data visualisation: charts。棒グラフの軸、グラフに添える説明・データ・代替テキスト。初回公開表示は2022年5月19日。